每一环都由最合适的模型与人工判断共同完成。人工判断只做两件事 —— 方向与取舍。
把「想说的」变成「该说的」
先定传播目标与受众,再让多个模型并发出稿,最后由人定调 —— 方向错了,后面全错。
与客户沟通明确传播目标、受众画像、投放平台与禁区口径。
GPT、DeepSeek 同时生成多版创意方向,方便客户选择适合自己风格的路径。
基于本公司语料训练的模型统一内容语气与专业术语,过滤不符合平台发布要求的内容,让核心信息更精细。
从多版方向中定稿 1 版,锁定核心主张与表达边界。
模型负责产量,人对「该说什么」负责。
把定稿的主张,落成分钟级台本
15s / 30s / 60s 各有结构模板,口播字数按语速精确控制 —— 时长与节奏在脚本阶段锁死,后面环节不返工。
按平台时长套结构模板:开场钩子 / 信息节奏 / 行动点。
GPT / DeepSeek 出稿,字数按语速控制 —— 60 秒约 220 字。
通过公司内部模型,配合即梦、Updream、LibTV 等内容平台,生成人物、场景、道具等视觉资产。
每句标注情绪与画面提示,直接作为分镜输入;资产库文件同步与甲方确认,便于后续分镜画面制作。
脚本锁死时长与节奏,分镜与生成阶段不再返工。
把脚本翻译成镜头语言
分镜是 AI 生产的施工图 —— 一致性锚点在这里建立,生成阶段才不会「每帧换一张脸」。
运用公司自训练大模型,为每句台词对应景别、运动、时长与转场方式。
每个镜头生成 2–3 版参考图,先确认再进入生成。
角色形象、产品外观、色调风格建立锚点,全片贯穿。
分镜确认后锁定方向,生成阶段不再改路线。
分镜是全流程里唯一「可以便宜地改」的环节 —— 确认后生成,成本才可控。
按镜头选型,不为一个模型赌上整条片
模型池按周更新。哪个模型擅长人物、哪个擅长产品与运动,由镜头属性决定,不由习惯决定。
DeepSeek / GPT 针对分镜脚本,生成对应平台的详细提示词。
Seedance 2.0 / 2.5、MiniMax 结合具体需求,逐镜头生成视频片段。
对出现原则性错误的片段进行筛选与重跑,保证每帧的准确性。
逐片段审核,确保成片片段不出现问题、整体符合脚本。
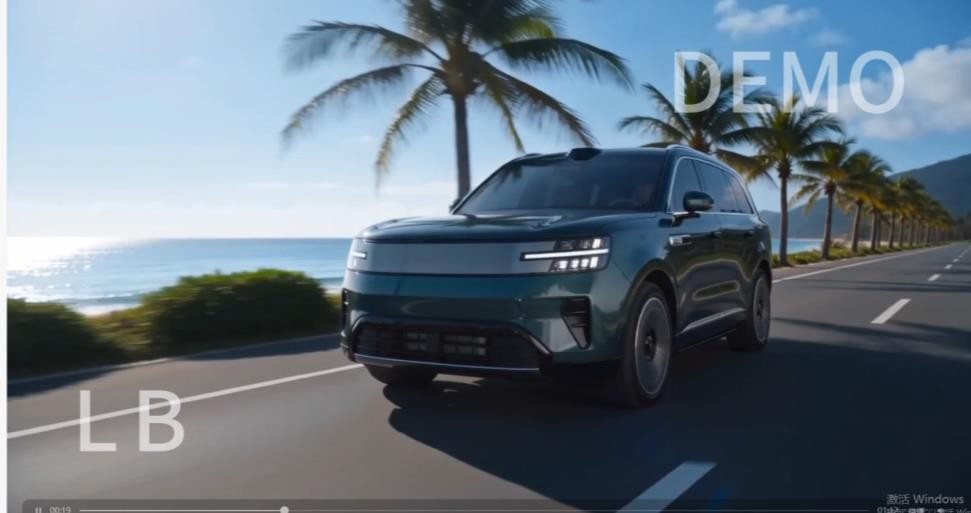
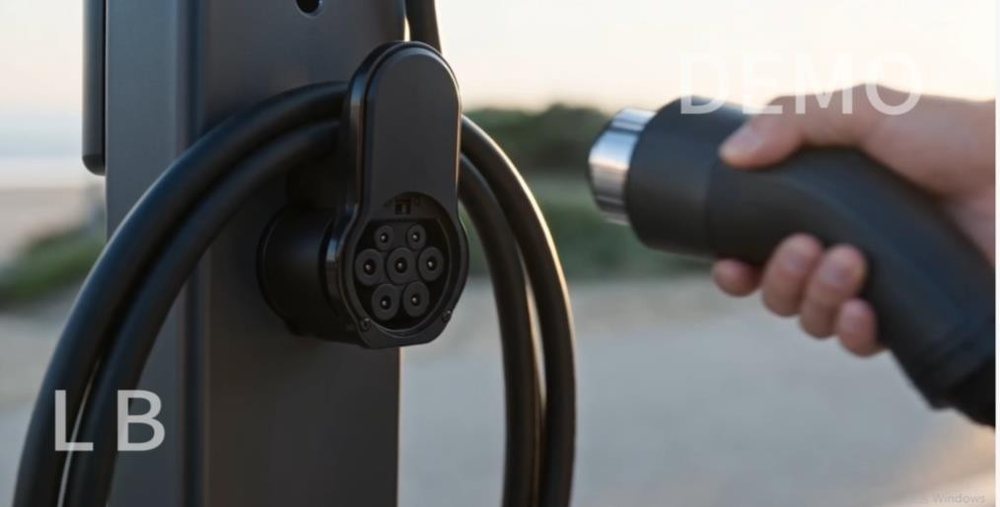
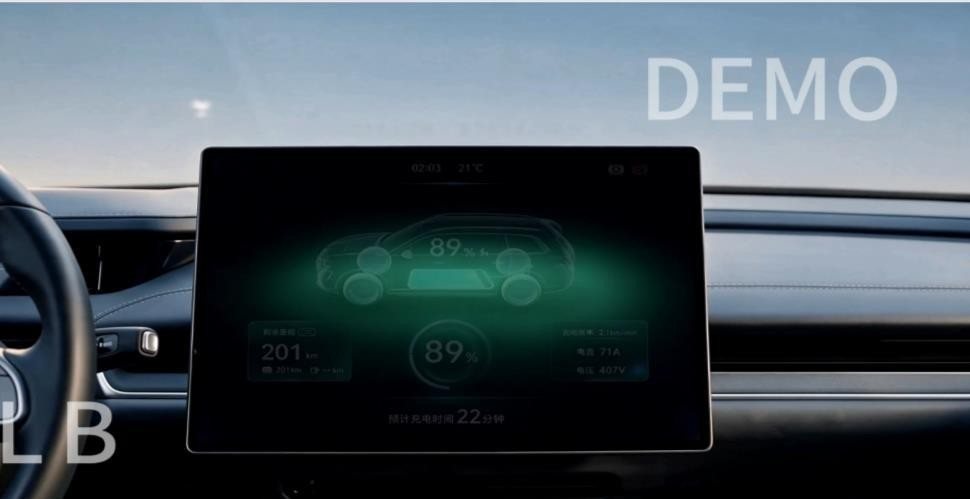
并行多版本,一个镜头同时出 3–4 版选优;单镜重跑,不合格镜头单独重生成,不拖整条片 —— 参考图锚点保证重跑不走样。
AI 生成的是素材,不是叙事
节奏与结构由剪辑师决定 —— 观众在第几秒被抓住,是设计出来的。
节奏与叙事结构重构、情绪点与开场钩子设计、多版本粗剪比选定稿。
统一影调与画风,配音 / 音效 / 配乐分层,口播字幕与品牌落版,响度按播出平台标准。
技术(分辨率 / 帧率 / 码率)、内容(事实 / 合规 / 肖像权)、品牌(VI 与口径)三层过检;输出 16:9 / 9:16 / 4:3 / 3:4 各版本,工程与素材归档入库。
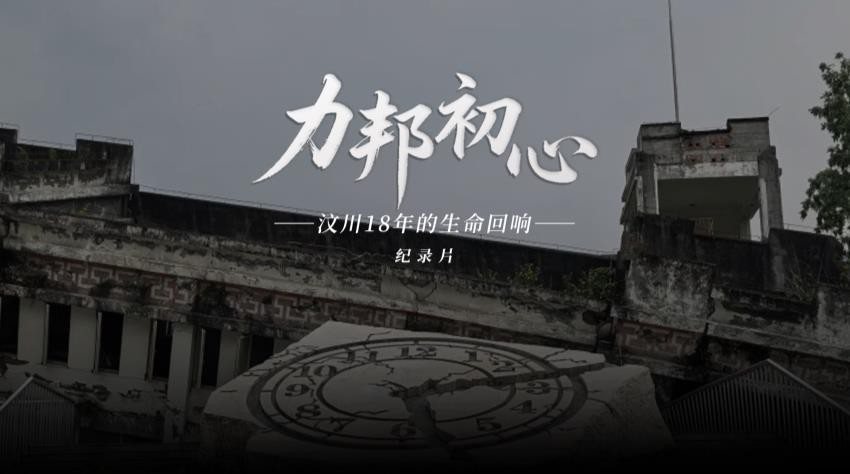
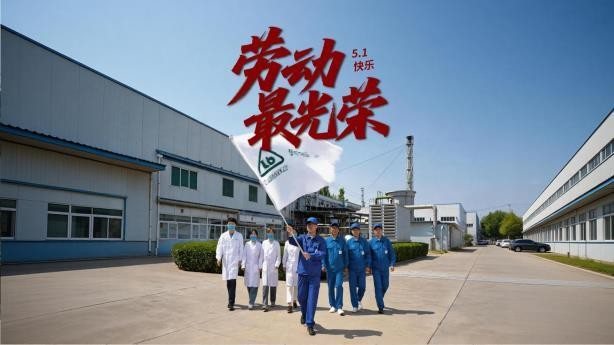
交付物是可直接播出的成片,不是 AI 生成的片段。
医疗、金融、新能源客户的共同点是:错一个字就发不出去。三类行业都跑通了,其余行业没有额外风险。
分辨率、帧率、码率、剪辑点、音画同步、响度。逐项过一遍,不靠肉眼判断。
事实核对、合规口径、肖像权与素材授权。医学与金融内容交由客户专业审核后再定稿。
VI 使用、字体与色彩、品牌落版、话术口径 —— 与客户既定规范逐条对照。
从多版创意方向中定稿,锁定核心主张与表达边界。
逐片段审核,确保画面符合脚本,再进入成片交付。
Everything you can imagine is real
Lipont AI Studios · 力邦文化产业集团